

Tiếp nối đà phát triển thần tốc của phiên bản 3.7 Flash, Google đã chính…
Giới thiệu khả năng hiểu video chủ động với Gemini
Hôm nay, Google ra mắt tính năng hiểu video theo cơ chế tác nhân (agentic video understanding) trên các mô hình mới nhất của mình: Gemini 3.7 Flash, 3.6 Flash và 3.5 Flash-Lite. Khả năng mới này giúp cải thiện độ chính xác, đồng thời giảm đáng kể lượng token sử dụng và chi phí cho việc phân tích video. Tương tự như khả năng thị giác theo cơ chế tác nhân (kết hợp việc thực thi mã lệnh với khả năng hiểu hình ảnh tích hợp sẵn của các mô hình Gemini), tính năng hiểu video theo cơ chế tác nhân tận dụng các công cụ xử lý video tích hợp của Gemini để nâng cao hiệu suất và mở ra những khả năng mới, chẳng hạn như truy xuất khoảnh khắc với độ trễ dưới một giây, phát hiện bất thường chính xác hơn, đếm đối tượng với độ chính xác cao, v.v.
Tính năng này hiện đã có sẵn cho các video tải lên và video YouTube thông qua Gemini API trong Google AI Studio cũng như nền tảng Gemini Enterprise Agent Platform.
Các tiêu chuẩn đánh giá
Khác với phương thức xử lý “tĩnh” hiện nay—nơi mô hình tiếp nhận video theo tốc độ khung hình cố định (mặc định là 1 FPS, có thể điều chỉnh qua API)—khả năng hiểu video theo cơ chế tác nhân (agentic video understanding) kết hợp năng lực suy luận cốt lõi của mô hình với các công cụ xử lý video chuyên dụng. Sự kết hợp này cho phép mô hình chủ động tìm kiếm, quét và kiểm tra các phân đoạn video mục tiêu dựa trên sự phối hợp giữa khung hình, âm thanh và nội dung lời thoại (transcript). Trên các bộ tiêu chuẩn đánh giá phân tích video phổ biến, các mô hình Gemini sở hữu khả năng này giúp giảm tới 66% chi phí phân tích và 88% lượng token tiêu thụ, đồng thời cải thiện độ chính xác lên đến 7%.
Những lợi ích về hiệu suất này đặc biệt rõ rệt đối với các video có thời lượng dài (từ video hướng dẫn 10 phút đến các bài giảng 90 phút hay các bản ghi hình kéo dài nhiều giờ); trong các trường hợp này, phương thức xử lý tĩnh buộc các nhà phát triển phải lựa chọn giữa chi phí token cao hoặc các kỹ thuật xử lý làm mất đi những chi tiết quan trọng.
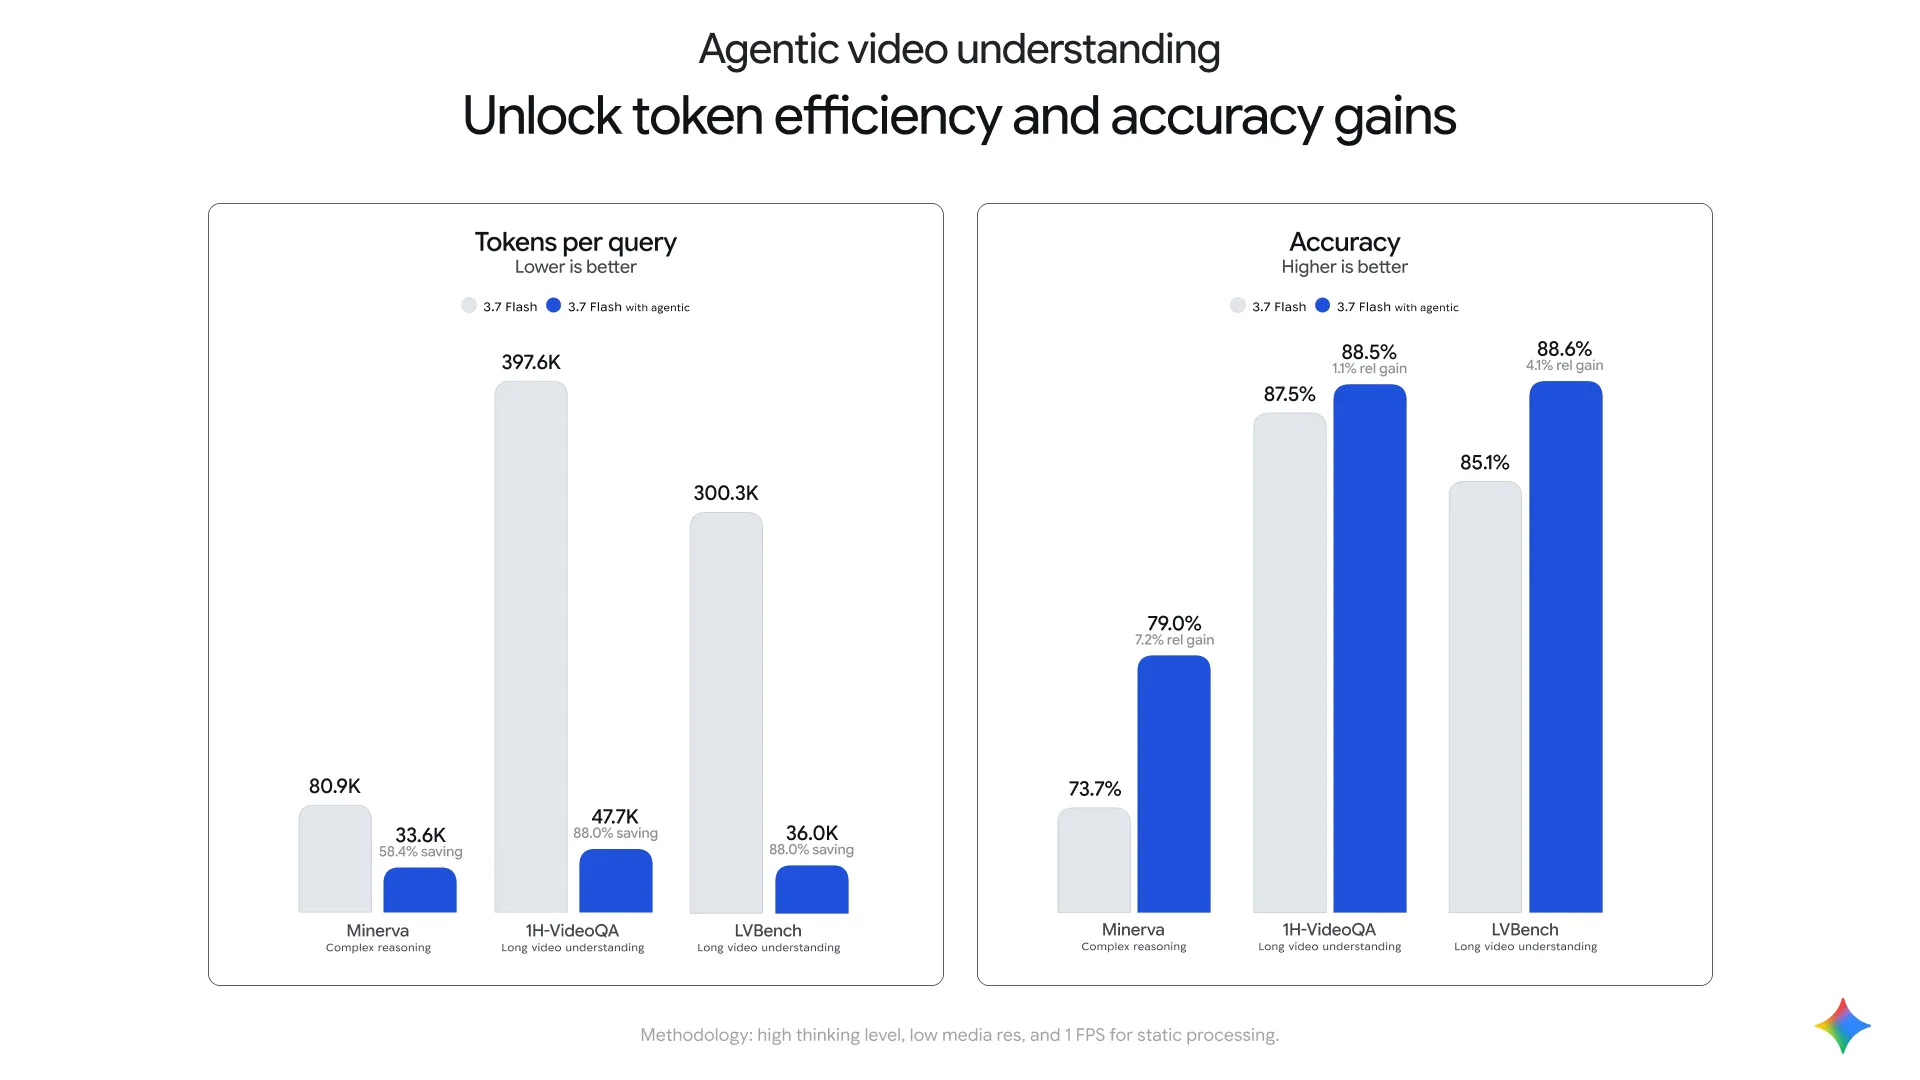
Việc kích hoạt khả năng hiểu video mang tính chủ động (agentic video understanding) giúp giảm mức tiêu thụ token tới 88% và tăng độ chính xác lên tới 7% với Gemini 3.7 Flash.
Mặc dù những cải tiến này áp dụng cho cả ba mô hình được hỗ trợ, Gemini 3.7 Flash với khả năng hiểu theo cơ chế tác nhân (agentic understanding) mang lại chất lượng tổng thể tốt nhất cũng như sự cân bằng tối ưu giữa chất lượng và chi phí, đưa mô hình này đạt đến “biên Pareto” về tỷ lệ độ chính xác/chi phí trong số các mô hình được thử nghiệm cho tác vụ hiểu video.
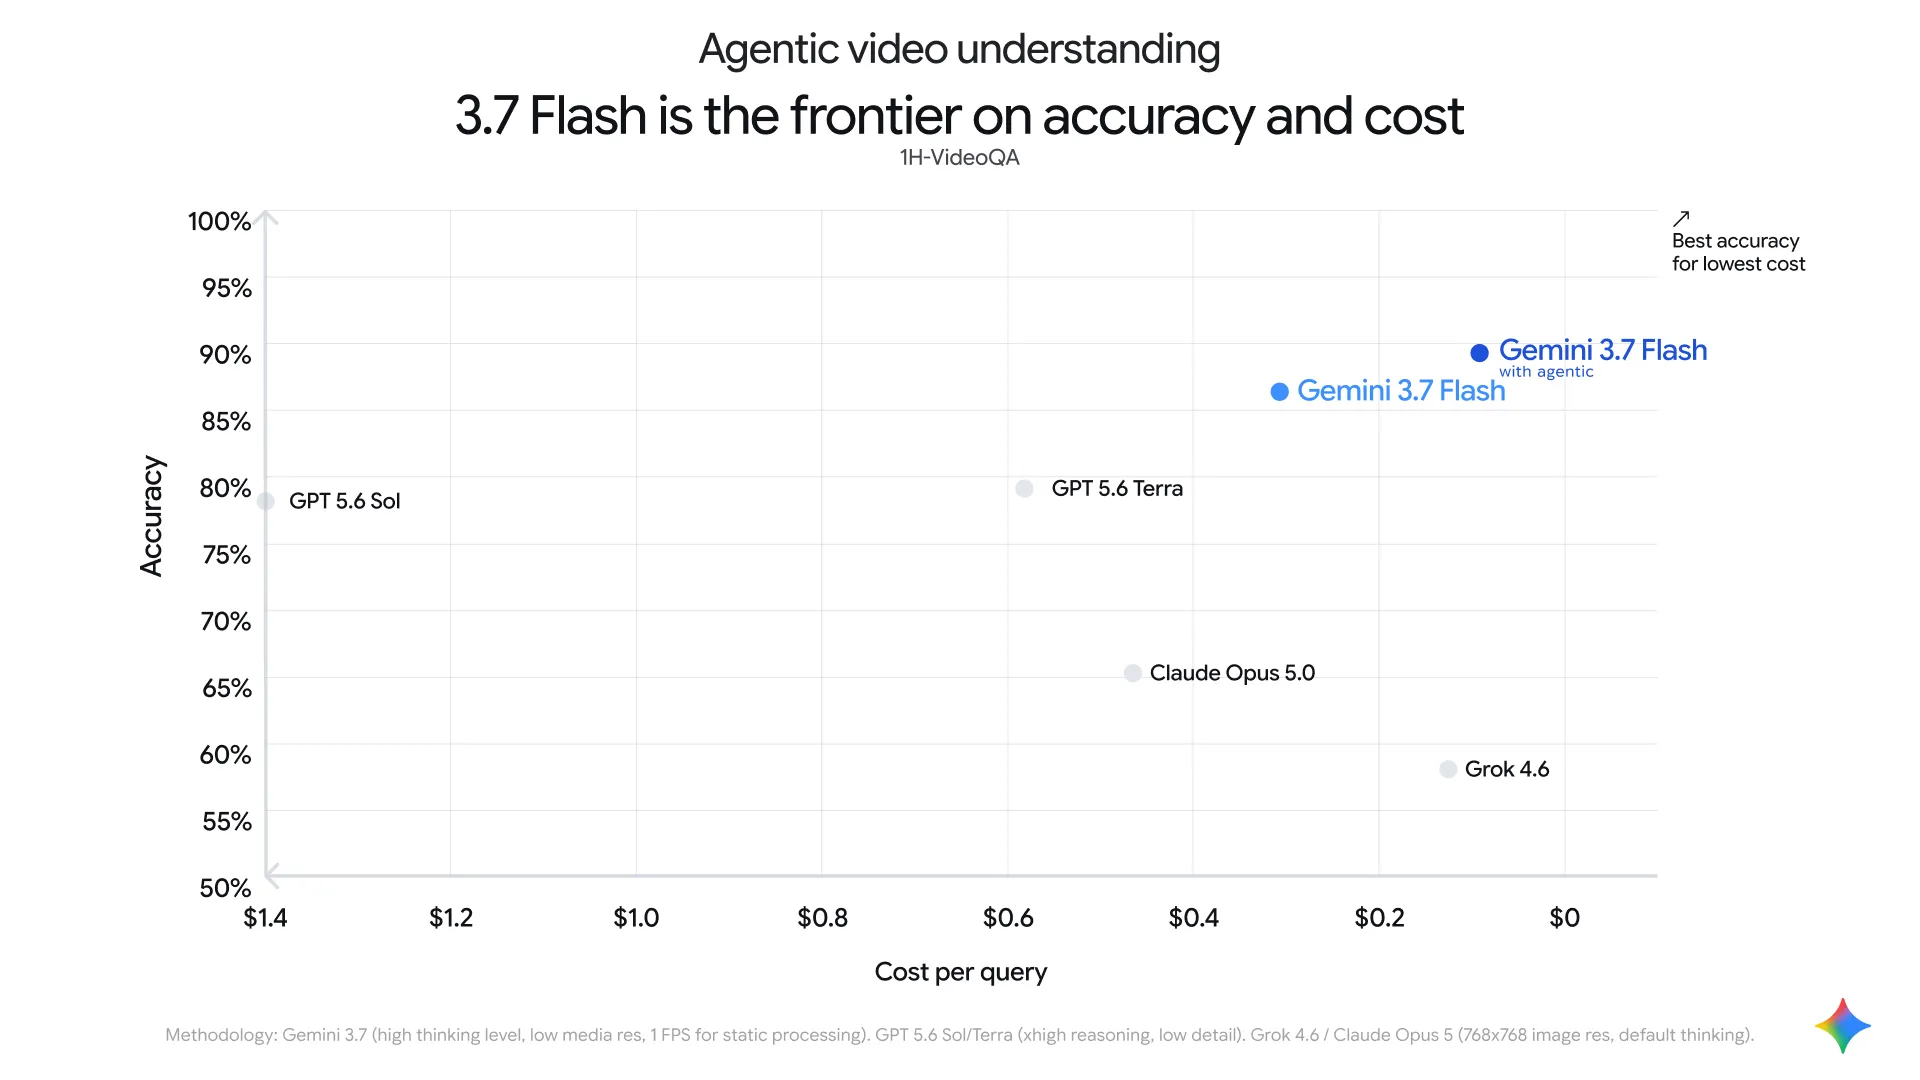
Việc ứng dụng khả năng hiểu video mang tính chủ động (agentic video understanding) giúp Gemini 3.7 Flash đạt đến điểm tối ưu trên đường biên Pareto về tỷ lệ giữa độ chính xác và chi phí trong lĩnh vực phân tích video.
How it works
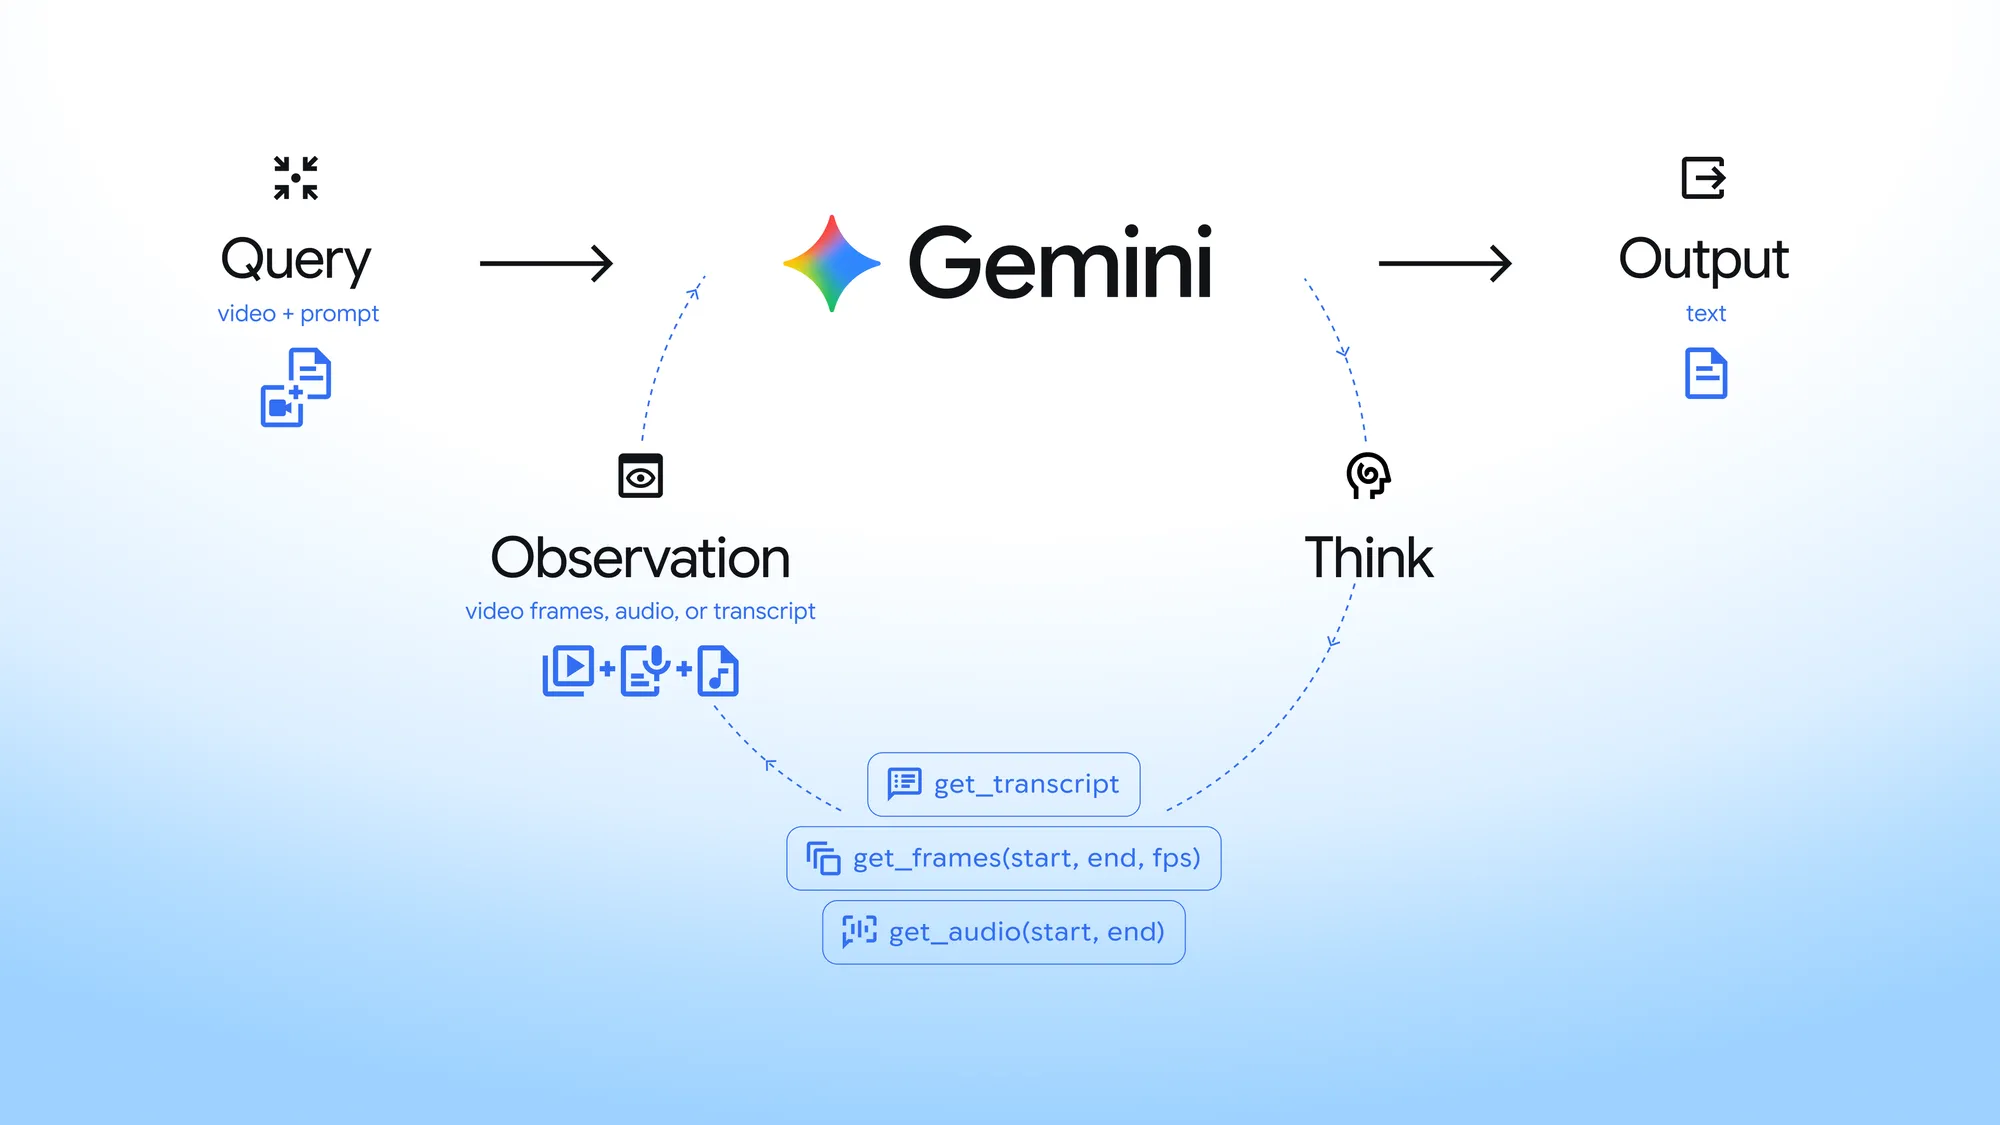
Thay vì phương thức xử lý tĩnh—nơi mô hình tiếp nhận các luồng dữ liệu đa phương tiện ở tốc độ khung hình cố định—khả năng hiểu video theo cơ chế tác nhân (agentic video understanding) cho phép Gemini đóng vai trò chủ động và có định hướng mục tiêu. Mô hình có thể tự quyết định nội dung cần xem, tốc độ xem cũng như phương thức tiếp nhận thông tin (qua khung hình, âm thanh hay bản ghi lời thoại) và chỉ trích xuất những khoảnh khắc hay tín hiệu thực sự cần thiết. Trước đây, các nhà phát triển thường phải thực hiện quy trình này theo cách thủ công; nay với khả năng hiểu video theo cơ chế tác nhân, Gemini có thể tự động hóa công việc này thông qua một vòng lặp tác nhân (agentic loop) bằng cách kích hoạt công cụ nội bộ để tải đúng phần dữ liệu video liên quan, qua đó giúp giảm đáng kể khối lượng công việc và chi phí phát triển.
Các khả năng và trường hợp sử dụng
Khả năng hiểu video theo cơ chế tác nhân (agentic video understanding) thay đổi cách các nhà phát triển xử lý nội dung video dài trong nhiều ứng dụng đòi hỏi khắt khe.
- Truy xuất khoảnh khắc dưới giây: Xác định chính xác các thay đổi trạng thái trong tích tắc và ranh giới cắt chặt chẽ dễ bị bỏ qua ở tốc độ 1 FPS, giúp có thể chỉnh sửa video tự động chính xác.
- Tìm kiếm thủ công dạng dài: Trả lời các truy vấn phức tạp trên các video dài nhiều giờ mà không tiêu tốn hàng triệu mã thông báo.
- Phát hiện bất thường: Lấy mẫu lại các cửa sổ thời gian thú vị ở FPS cao hơn để kiểm tra chuyển động nhanh và các tạo tác hình ảnh tinh tế.
- Đếm hành động & đồ vật: Theo dõi chính xác các chuyển động vật lý lặp đi lặp lại và các đồ vật riêng biệt theo thời gian.
Kết quả thực tế
Nhiều đối tác tham gia chương trình trải nghiệm sớm của Google đã ghi nhận hiệu suất ấn tượng khi thử nghiệm tính năng hiểu video dựa trên tác nhân (agentic video understanding). Dưới đây là những chia sẻ của họ:
“Revyl giúp các đội nhóm phát triển và kiểm thử ứng dụng iOS và Android một cách tự động hóa thông qua các thiết bị đám mây của chúng tôi. Hệ thống thị giác độc quyền của Revyl có thể điều hướng ứng dụng như một người dùng thực thụ, nhưng phương pháp xác minh dựa trên ảnh chụp màn hình lại dễ bỏ lỡ các khoảnh khắc chuyển động nhanh. Bằng cách vượt qua giới hạn này, công nghệ Agentic Video Understanding (Thấu hiểu Video Tự động) cho phép chúng tôi phát triển và kiểm thử hiệu quả ngay cả những ứng dụng có nhiều hiệu ứng hình ảnh phức tạp.”
Ethan Zhou, Growth Engineer, Revyl
“Đội ngũ của chúng tôi đã đưa mô hình Agentic Video Understanding vào thử nghiệm trực tiếp với hệ thống Gemini hiện tại trên hàng nghìn video được gán nhãn và một quy trình phát hiện deepfake theo thời gian thực. Trong khi các mô hình của chúng tôi xác định đâu là nội dung thật và đâu là sản phẩm của AI, Gemini sẽ diễn giải các kết quả đó thành những lời giải thích dễ hiểu. Mô hình mới đã mang lại mô tả và bối cảnh chính xác hơn cho các video dài, đồng thời giảm 57% lượng token đầu vào, giúp chúng tôi cung cấp kết quả chất lượng hơn với chi phí thấp hơn.”
Zohaib Ahmed, Đồng sáng lập & CEO, Resemble AI
“Agentic Video Understanding đã tạo ra sự khác biệt rõ rệt nhất khi xử lý các thước phim gốc dài và phức tạp—yếu tố quan trọng đối với các AI Agent chuyên về video. Trong các bài đánh giá theo quy trình mô phỏng thực tế của Mosaic, công nghệ này đã giảm 97% lượng token đầu vào trung bình, tăng gần gấp đôi phạm vi đáp ứng các yêu cầu ràng buộc, và là chế độ duy nhất hoàn thành được case study xử lý podcast dài 4.5 giờ của chúng tôi.”
Adish Jain, CEO, Mosaic
“Tại Ponder, chúng tôi đã tự xây dựng một quy trình thấu hiểu video tự động dựa trên Gemini để tìm ra những khoảnh khắc có giá trị từ các cảnh quay thô. Công nghệ Agentic Video Understanding của Google đã gói gọn quy trình điều hướng đó chỉ trong một lệnh gọi duy nhất, đạt được hiệu suất tương đương với hệ thống của chúng tôi nhưng chỉ sử dụng lượng token đầu vào ít hơn khoảng 3.5 lần.”
Ibrahim Syed, Founding Engineer, Ponder
Getting started
Khả năng hiểu video của tác nhân có sẵn thông qua API Gemini trong Google AI Studio và Gemini Enterprise Agent Platform, được triển khai trên các phiên bản Gemini 3.7 Flash, 3.6 Flash và 3.5 Flash-Lite. Dịch vụ này áp dụng cơ chế tính phí theo token tiêu chuẩn của Gemini API và không thu thêm phí tính năng.
Google cũng đang mang những cải tiến về hiệu suất và chất lượng của công nghệ hiểu video theo cơ chế tác nhân (agentic video understanding) đến với hàng tỷ người dùng trên các sản phẩm của Google. Tính năng này sẽ sớm được triển khai cho tất cả người dùng ứng dụng Gemini, áp dụng trên cả hai mô hình Flash và Flash-Lite. Ngoài ra, trong những tháng tới, công nghệ này cũng sẽ hỗ trợ tính năng “Ask YouTube” trên trang xem video của YouTube, tận dụng sức mạnh của Gemini để cung cấp các câu trả lời chất lượng cao hơn, bám sát nội dung hình ảnh trong video.
Related Posts